上周翻手机相册,想找一张去年冬天拍的照片——一只橘猫趴在暖气片上,尾巴耷拉下来。我记不住日期,也记不住城市。就打了四个字:猫、暖气片。它搜出来了。
三个词,两个名词。它凭什么知道?
说实话,它根本不认识“猫”这个字。它认识的是另外一套东西。
关键词搜索的死胡同
以前我们搜东西,靠的是匹配。你输入什么字,它就去翻哪些字。这叫倒排索引,本质上是个极其勤奋的抄写员——你给它字,它给你含这些字的文档。
问题来了。照片里没有字。
所以早年间的图片搜索,全靠人工打标签。谁打的?运营同学或者众包。打完了你才能搜。标签里写了“猫”你搜猫能中,标签里只写了“宠物”,你搜“猫”就一片空白。至于“一只看起来很困的猫”——没人会这么打标签。太累了。
麻烦在于,人的表达是发散的。你想搜“小轿车”,图库里标的是“汽车”。你想搜“有点丧的电影”,数据库里只有“剧情片”“文艺片”。字面上八竿子打不着,可你自己心里清楚,你要的就是那个东西。
向量数据库想解决的,就是这个“心里清楚但说不出来”。
它的思路有点笨拙又有点聪明:把每张图、每句话、每首歌,统统变成一串数字。几百个、几千个数,排成一队。这一队数字,叫向量。

一串数字怎么就有“意思”了
你可以这么理解:给每张照片写一份超长的口味报告。
色调暖不暖。有没有毛绒质感。构图是居中还是散开。画面里有没有活物。明暗对比强不强。是室内还是户外……维度多到离谱,可能上千项。每一项打一个分。
打完分,这张照片在数学上就变成了空间里的一个点。
关键在于:意思相近的东西,它们的点挨得近。
“猫”这个点和“狗”这个点,距离不算太远,因为它们在毛绒、活物、暖色调这些维度上表现接近。但“猫”和“挖掘机”的点,隔了十万八千里。
于是搜图这件事就变成了几何题:把你输入的那句话也变成一个点,然后找离它最近的几个点。就这么简单。距离一般用余弦相似度来算,两个向量的夹角越小就越像。
有点意思的地方在于——没有人告诉过机器“猫是动物”。它是在海量数据里自己把周围挤成那个样子的。你说不清楚这是学习还是本能。反正结果是,它大概知道哪些东西属于一伙。
这有点像什么?像一个在城市里住久了的人。不用看地图,走到路口就知道拐过去是菜市场。你问他怎么知道的,他也说不出个所以然。

关于它,误会实在太多了

第一个误会:以为是新版数据库,能替代 MySQL。
不能。它不擅长精确查询。你问“订单号 A1234 现在什么状态”,这种活儿请老老实实交给关系型数据库。向量数据库擅长的只有一件事:找相似的。它在图书馆里的角色,是那个你跟他描述“我最近想看那种,有点压抑但是最后又有点希望的书”,然后他能给你抱来三本的人。他不管书在第几排第几架。
第二个误会:以为它自带 AI。
也不是。向量不是它算的,是嵌入模型算的。数据库只管存和找。模型靠谱,找得准;模型拉胯,你存得再整齐也没用。我见过有人折腾了半个月索引参数,最后发现是自己选的嵌入模型压根不适合中文短句——跟数据库一点关系都没有。
第三个误会:以为必须几十亿条数据才用得上。
真不是。几千条也能跑。一个公司内部的客服问答库,几百条标准问题配几千条变体,用它做模糊匹配就很香。别被那些架构图吓到。
“差不多找到”,才是它的核心手艺
传统搜索的做法是:把所有数据挨个比一遍,然后排出最准的那个。绝对不落下。可当数据量涨到几千万上亿条,这活儿干不动了。太慢。
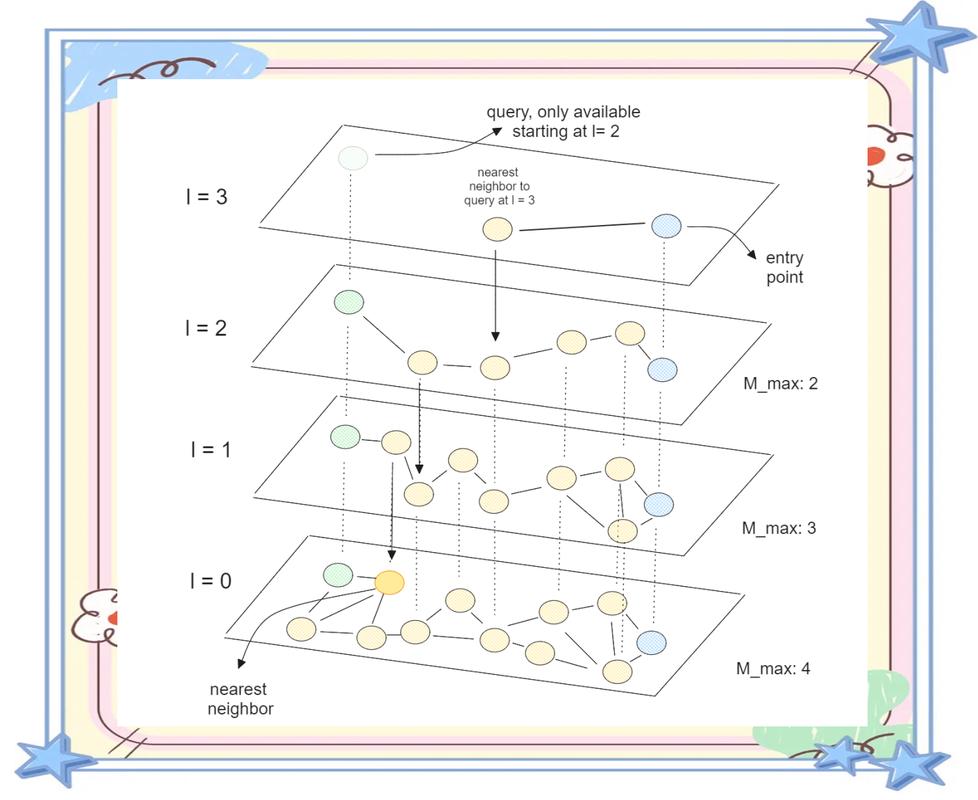
所以现在的向量数据库,基本都主动放弃了“绝对准确”。它们用近似最近邻检索——先用某种索引结构大致圈出一块可能区域,再在里头细找。速度能快几十上百倍,代价是有可能漏掉一两个其实最像的。
这事特别像在地下车库找自己的车。
车库八百个车位。你不可能一个一个看过去。但你记得:大概停在 B 区,靠着柱子,旁边有辆白色 SUV。于是你直奔 B 区。运气好三十秒就看见它了;运气不好,记错了,跑到了 C 区,得绕一圈回来。
大多数时候,它够用。而且这里头有个旋钮可以拧:想快一点就牺牲召回率,想准一点就慢一些。每个人按自己的场景调,没有标准答案。
它其实一直在你手机里干活
你可能压根没听过这个词。但大概率每天都在用它。
相册里搜“狗”“海边”“蛋糕”,搜得出来——背后十有八九就是向量检索在运转。
音乐软件的“猜你喜欢”,为什么推的歌你会喜欢?它把每首歌变成一个点,然后找离你最近的那一片。
电商页面那个“找相似”按钮,点一件衣服跳出来一排——它比的根本不是款式名称,是那些衣服在数学空间里的距离。
还有论文查重、找相似文献、某些客服机器人。你问一句语法不通、错字连篇的话,它照样能从几百条标准问答里挑出最接近的那条。因为有时候,它根本不看你的字,只看你的“味儿”。
对,就是闻味儿。
把每样东西的味道都写下来:这张图是暖的、毛的、软的;那句话是酸的、抱怨的、不太客气的。然后你拿一股新的味道过来问一句——还有谁是这个味儿?
它不认识猫。它只是觉得,这个味儿,跟前年那只橘猫挺像。
如果你想动手,几句掏心窝的话
别一上来就搞集群,真的。几百条数据,本地用个轻量库加个索引文件就能跑起来。先跑通,再谈性能。
把八成精力放在嵌入模型上。这块决定了天花板。数据库选哪个,很多时候只是手感问题。
凡是带“相似”“大概”“最像”这几个字的需求,都要接受它偶尔抽风。它给的是概率上的好,不是绝对的正确。
还有一点,别把它想得太玄。它就是一个特别擅长找相似东西的储物柜。储物柜本身不等于智能。可没有它,很多看起来很智能的东西,其实压根跑不起来。
我后来又搜了一次。这回打了六个字:毛茸茸、冬天、趴着。第一张就是它,尾巴还是耷拉着的那种。
有点好笑。我说不清它凭什么,但确实就是它。