我侄子今年五岁,最近迷上一个游戏:把一杯清水滴进一滴墨水,然后盯着看它慢慢晕开。
他觉得很神奇。我觉得这有啥神奇的。
然后我打开电脑,用AI画了张图。他看着空白的画布上一点点浮现出云朵、山峦和湖面,眼睛瞪得比看墨水还大。
我说:这俩其实是一回事。他不信。但说实话,扩散模型的核心逻辑,跟墨水在水里晕开、再倒着放一遍,真的没差太多。
先别管公式,看一个生活场景
你泡过奶粉吧?或者冲过藕粉?
一勺粉倒进碗里,加水,搅两下。刚开始是黏糊糊的一团疙瘩,继续搅,慢慢变成细腻的糊状。这个过程你没法一步到位,得慢慢来。
扩散模型干的事情,反过来。
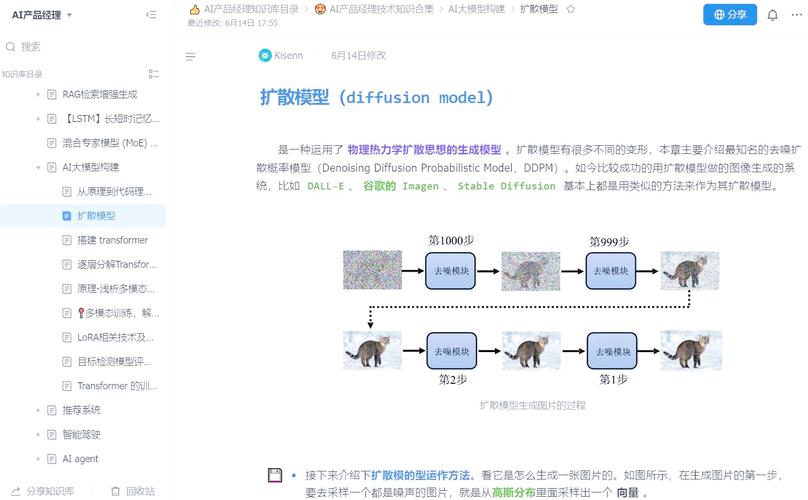
它先把一张清晰的图片“搅糊”——铺上一层又一层的噪点,直到图片变成纯雪花屏。这步叫加噪。然后,它学着怎么从这团雪花里,一步步把原来的图像“搅回来”。

训练的时候,模型看了无数张图片,每张都经历一遍“变糊再还原”的过程。看多了,它就摸清了门道:哪种噪点分布对应什么形状的边缘,什么样的模糊纹理暗示着人脸还是汽车。
注意,它学的不是“画出一只猫”,而是“从一团乱麻里,怎么把线条一根根理顺”。
所以当你输入“一只橘猫坐在窗台上”的时候,模型是从一个完全随机的噪点图开始,一步步去掉噪点,最终“析出”一张符合描述的图像。每一步都只是微调,去一点噪,再对照文字信息判断方向对不对。几百步下来,图就出来了。
慢,但是稳。
为什么非得这么绕?直接画不行吗?
这是个好问题。我当初也卡在这儿。
你想,如果让模型一步从文字变出高清图片,那难度相当于让你闭着眼睛单手拼完一个五千块的拼图。它得一次性猜对所有像素的排列组合。可能吗?
不太可能。就算勉强做出来,结果也经常是模糊的、扭曲的、五官错位的。
扩散模型的思路是:别一口吃成胖子,每次只走一小步,但每一步都走对方向。
从纯噪点开始,去一点噪,问自己“这团东西现在像不像一只猫?不太像,那就往猫的方向调整一点”。重复几千次。最后那张图,自然就浮现出来了。
说白了,它把“画图”这个难题,拆成了几千个“去噪”的小题。
这就好比你要搬一百块砖上五楼。一口气扛一百块?你扛不动。但每次搬一块,上下跑一百趟,虽然累,但能完成。
扩散模型就是那个勤快的搬砖工。
你以为它“画”图,其实它一直在“猜”

有个误解特别普遍,我得掰扯一下。
很多人觉得,AI画图是“从数据库里找了一张最像的拼出来”。不是的。它没有图库,它甚至不“知道”猫是什么。
它做的事情是:给一堆随机噪点,问“这里面可能藏着什么”,然后一点一点把答案逼出来。
就像你看着天上的一朵云,觉得像狗,又觉得像兔子。云本身没有形状,是你大脑在“去噪”——把无意义的信号解读成有意义的图案。
扩散模型没有眼睛,它只有数学。但它干的事情,跟你的视觉系统处理模糊图像时的逻辑,惊人地相似。
你看到一张模糊的照片,第一反应是“这好像是我朋友”,然后定睛一看,确认了。扩散模型的每一步去噪,就是在做类似的“确认”。
所以它不是在“创作”,它是在“还原”——还原一个在噪点里藏着的、符合你文字描述的图像。
当然,这个“还原”出来的东西,可能是全新的,从来没存在过的。这也是为什么AI画出来的手指头经常多一根或者少一根。它猜过头了。
说到手指头,这事儿挺有意思
你有没有发现,早期的AI画图,最怕画手?
五根手指,能给你画成七根,或者像融化的蜡烛一样黏成一团。
原因也不复杂。手指的结构太精细了。每根指头就那么几个像素宽,关节的弯曲角度、指尖的弧度、指甲的位置——这些东西在噪点里是很容易被“猜错”的。
去噪去到最后几步,模型已经大概知道这是只手了,但手指头的细节信息在之前的步骤里丢得差不多了,只能瞎猜。一猜就多一根。
不过这两年这个问题已经好很多了。因为训练数据更多了,模型见的“手”多了,知道正常的比例大概是什么样。更重要的是,训练时编码器对文字描述和图像细节的绑定更紧密了,你说“五根手指”,它会更认真地数一数。
但依然会翻车。也别太苛求。毕竟人类画师画手也经常翻车,对吧。
还有个有趣的事情。扩散模型生成图像时,如果你用的步数太少,比如只去噪十步,出来的东西就很糊、很抽象。步数太多,又可能因为过度去噪而显得油腻、不自然。
这中间的平衡,有点像炒菜的火候。火小了夹生,火大了焦糊。全凭经验。
所以AI画图软件里那个“步数”滑块,你别小看它。它决定了模型愿意花多少耐心,去“还原”你描述的那个画面。
扩散模型不只用来画画
我知道你可能觉得,说了半天就是个画图工具。
其实不是。
语音合成用它。你听到的那些AI配音,很多也是从噪点里“析出”声音波形的。
视频生成用它。让每一帧图像在时间轴上也保持连贯,相当于在二维去噪的基础上,加了一维“时间”。
甚至写代码、设计蛋白质结构,都有人在用类似扩散的思路。
为什么它这么通用?
因为它的本质,是一个从混乱中找秩序的通用框架。只要你能把问题定义成“从一堆噪声里还原出目标”,扩散模型就能派上用场。
图片是像素的噪声,声音是波形的噪声,文字是token的噪声。套路都一样。
这也是为什么这几年扩散模型火得一塌糊涂。它不只是技术进步,它更像一把万能钥匙,能打开很多不同的锁。
当然,它也不是万能的。算力消耗大,生成速度慢,有时候还会一本正经地胡说八道。但这些并不妨碍它成为当前最受关注的AI技术之一。
最后说个我自己的小感受

我第一次搞明白扩散模型原理的时候,有种说不出的感觉。
就像小时候看魔术,不知道机关在哪,觉得神秘极了。后来有人把机关拆开给你看,发现原理其实特别朴素——甚至朴素到有点失望。
但转念一想,最牛的技术往往就是这样。不是用了多复杂的魔法,而是把一个简单的道理,重复了足够多次,调参调得足够精细,然后奇迹就发生了。
就像我侄子看墨水在水里晕开,觉得神奇。我告诉他这是扩散。他说,那又怎样?
是啊,那又怎样。但知道这个之后,你再看AI画出来的图,感觉不一样了。
你能想象到,那些逼真的光影背后,是几千次笨拙的“去噪”和“微调”。是无数张被故意“搅糊”的图片,是模型在黑暗中摸索着,一点一点把光找回来。
有点笨。但挺动人的。
下次你用AI生成图片的时候,可以留意一下进度条。每往前走一格,模型就离你描述的那个画面近了一步。从一团乱麻,到眉眼清晰。
这个过程中藏着的东西,比最终的画面,更有意思。