上周三傍晚,我蹲在小区门口等儿子放学,旁边一位妈妈正对着手机屏幕叹气。凑过去一看,是某款口算App推送的周报——孩子每道题的作答时间、正确率、错题类型,甚至”犹豫了12秒”这种细节都标得清清楚楚。她皱着眉说:”这些东西,连我自己都不知道,平台倒先知道了。那以后呢?”
她没往下说,但我懂那个”以后”是什么。是初中分班时,会不会有机构根据小学的专注力数据,提前给孩子贴上标签?是若干年后,那些”犹豫12秒”的瞬间,会不会成为某种评价系统里的暗码?
说实话,这几年我陆陆续续走访过二十多所中小学,和上百位老师聊过天。一个越来越普遍的焦虑是:教育数字化的油门踩得越猛,孩子们的数据尾气就排得越多。智慧课堂录下每一次举手发言,作业平台分析每一次深夜提交,校园一卡通记录每一次食堂消费。数据像灰尘一样,落在每一个角落,擦不掉,也管不住。
但另一面,我们又不愿意退回粉笔灰时代。没有数据,老师怎么知道那个坐在最后一排沉默的孩子,到底是懂了还是装作懂了?没有数据,家长怎么发现孩子运算速度突然掉下来,是不是睡眠出了问题?
这个矛盾,恰恰是隐私计算想解的题。它不是让大家断网,也不是把数据锁进保险柜,而是——让数据在”不见面”的情况下完成计算。
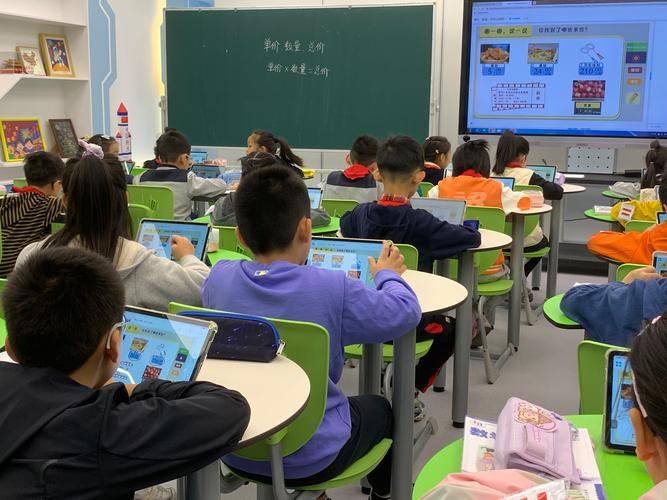
数据在哪里,风险就在哪里
先看一个真实的小场景。某校用了一套课后作业系统,老师能从后台看到全班每个孩子的错题分布。这本来是好事。但有一次,一位家长悄悄问我:”这套系统的服务器在哪儿?会不会哪天倒闭了,我孩子的错题本变成公开的数据库?”
他担心的不是技术本身,而是控制权的不对等。学校采购了系统,平台积累了数据,家长和孩子却不知道数据去了哪里、被谁用过、多久删除。这种”单向透明”让很多人心里不踏实。
隐私计算要解决的,正是这种不踏实。它有几个不同的技术路子,但核心逻辑是一样的:原始数据不动,计算结果可以动。打个比方,你想知道自己孩子在班里数学排第几,但不想让任何人看到孩子的具体分数。传统做法是把所有分数收上来,统一排名,然后告诉你一个名次——但这意味着你的分数也暴露给了统计者。隐私计算的做法,是让每个孩子的分数先”变换”成一种加密形态,系统只算出”你家孩子比30%的同学高”,不知道具体谁是多少分。
这有点像戴着毛玻璃手套握手。手是握了,但对方不知道你指纹长什么样。
我知道这个比喻不严谨,但意思是那个意思。关键点在于:教育数据的价值不应该建立在”看见每一个原始细节”上,而应该建立在”算出有用结论”上。
课堂上还远,但办公室和家校群已经用上了
有人可能会说,隐私计算听起来这么技术流,中小学能沾上边吗?
能。而且有些地方已经在用了,只是大家没注意。
比如某些区域的教育质量监测。以前要抽一个区所有学校的成绩数据,集中上传到市里,再统一分析。现在有的区在试点联邦学习:各校数据不出校门,本地训练一个模型,只把模型参数加密后上传。市里得到的是一个汇总后的分析模型,看不到任何具体学生的分数。
再比如家校沟通。有的学校用加密查询的方式做考勤通知。家长想知道孩子今天有没有迟到,系统会发一条”正常”或”迟到”的提醒,但学校后台看不到家长看了多少次、几点看的。这重要吗?说实话,挺重要的。有一次我听说某学校家长因为频繁被记录”已读不回”,被老师叫去谈话,家长觉得委屈:明明是在上班没来得及回。如果家校沟通工具记录了”阅读时间”和”回复时长”,这些数据被用来评价家长”配合度”,那就已经变味了。
隐私计算在这里扮演的角色,不是让数据消失,而是让数据不该被看见的部分真正隐身。

别急着上技术,先理清三个问题
不过,我这人有个毛病,看到新技术不先看它能干什么,先看它容易在哪里翻车。隐私计算在中小学落地,有三件事必须先想清楚。
第一,谁来定义”隐私”?同一个数据,在不同场景下性质完全不同。考试成绩在班级排名场景里是个人隐私,在全区教学质量分析场景里是统计样本。隐私计算能让人看不到原始数据,但如果采集端本身就”过度采集”,那技术再好也只是帮凶。我见过一个学校的”智能课堂”系统,连学生举手次数、站姿幅度都列入分析维度。这跟隐私计算没关系,这是采集边界问题。
第二,老师用得起来吗?我一向对教育技术的”可用性”保持警惕。很多系统在演示时行云流水,一进真实课堂就卡壳。隐私计算如果只是技术供应商的卖点,而老师面对的是一个需要额外折腾的复杂流程,那它就会像很多”智慧黑板”一样,最后沦为展示课的道具。真正有用的方案,应该是老师不知道它存在,但每次操作都自动受保护。就像你发微信不会想着”我的消息被加密了”,但它确实加了。
第三,家长能理解吗?这一点我最没底。我做过一个很小的非正式调查,问了三十多位家长:”你知道孩子学校用的App收集了哪些数据吗?”只有三位说”大概知道”。十七位表示”从来没想过”。剩下的十位说”估计收集了不少,但也没办法”。这个回答里的无奈感,才是隐私计算真正要面对的。
技术解决的是”怎么算”,但教育场景里更难的,是”谁来决定怎么算”。
一个可以立刻做的小实验

说一个家长或老师这周就能试的事。
拿一张纸,画三列。左边写”学校要求孩子用的数字工具”,中间写”这个工具知道孩子的什么信息”,右边写”这些信息如果不经过这个工具,我还能不能知道我想知道的”。
比如,口算App知道了孩子的答题速度和错误模式。但作为家长,你其实只需要知道”他除法有点弱,建议多练”。中间那些原始数据——每道题犹豫了几秒、哪道题退回去改了——是不是必要的?
再比如,班级优化大师记录了孩子每一次加分减分的时间和事由。但作为老师,你其实只需要期末看到趋势图,不需要看到”周二下午第二节第三次加分的具体原因”。
这个练习不是为了立刻卸载所有App,而是为了看清楚:我们交出去的,往往比我们需要的多。隐私计算的意义,就是把这个差值补回来。它让数据”够用”,但不”过多”。
当然,我不是说所有学校都应该马上部署隐私计算方案。这既不现实,也没必要。但至少,我们可以开始问一些问题:学校采购数字工具时,有没有人评估过数据采集的边界?家长会上,有没有人解释过孩子的数据会被怎么用?教师培训里,有没有一节课讲数据素养?
这些问题的答案,比任何技术方案都重要。
我儿子今年四年级。他昨天问我:”爸爸,我们班的平板电脑会不会知道我在想什么?”
我说不会,但我知道,他提这个问题本身,就是进步。
至少比我们这一代人强。我们那时候,连问都没问过。